合成調査は、人間パネルのデータと同じように高度な分析に対応できる品質の合成データ(シンセティックデータ)を生成できて初めて真価を発揮します。そうでなければ、根拠のない思い込みに基づいて意思決定を下すリスクを抱えることになります。データが示している見かけ上の傾向と、実際の顧客心理との間に乖離があると、企業が目指すビジネス成果を得ることができません。
そこでクアルトリクスは、高度な統計分析にも耐えうる基本的な合成モデルを開発しました。この取り組みの重要性を理解するには、一般的な合成調査ツールがどのように構築されているのか、そして、そのアーキテクチャにはどのような限界があるのかを知る必要があります。
合成調査における汎用AIモデルの限界
汎用LLMは、入力された指示に対して確率的に最も確からしいテキストを予測して回答を生成します。例えば、「米国中西部で製造業に従事する28歳として回答してください」とペルソナを指定すると、モデルは主にインターネット上の学習データに含まれる文化的傾向や言葉遣いのパターンを再現して回答を作成します。アイデア出しや初期段階での仮説立案において、このアプローチは非常に有用です。
ところが、生成されたデータを 定量分析に利用しようとした途端、問題が発生します。人間のアンケート回答者から得られるデータには、回答に記載された好みと実際の行動との間の食い違いや、複雑・不規則な回答パターン、確信がない状況で意思決定する際の回答のぶれ(統計的ノイズ)といった、自然なばらつきが存在します。
ところが、汎用モデルはこうした ばらつきを平準化 (EN)してしまいます。回答は、そのペルソナが「典型的に選びそうな選択肢」に集中し、実際の人間から得られるサンプル群のような統計的分布を示しません。その結果、そのデータを 因子分析やクラスター分析、キードライバー分析にかけようとしても、それらの手法が前提とする構造的整合性に欠けているケースが少なくないのです。
もちろん、汎用モデルのこうした限界を補うために調査担当者が利用できる手法は存在します。この手法の違いを理解することが、現在市場に流通している合成調査ツール間で、結果の質に大きな差が出る理由を解き明かす鍵となります。
合成データを生成する3つの主要な手法
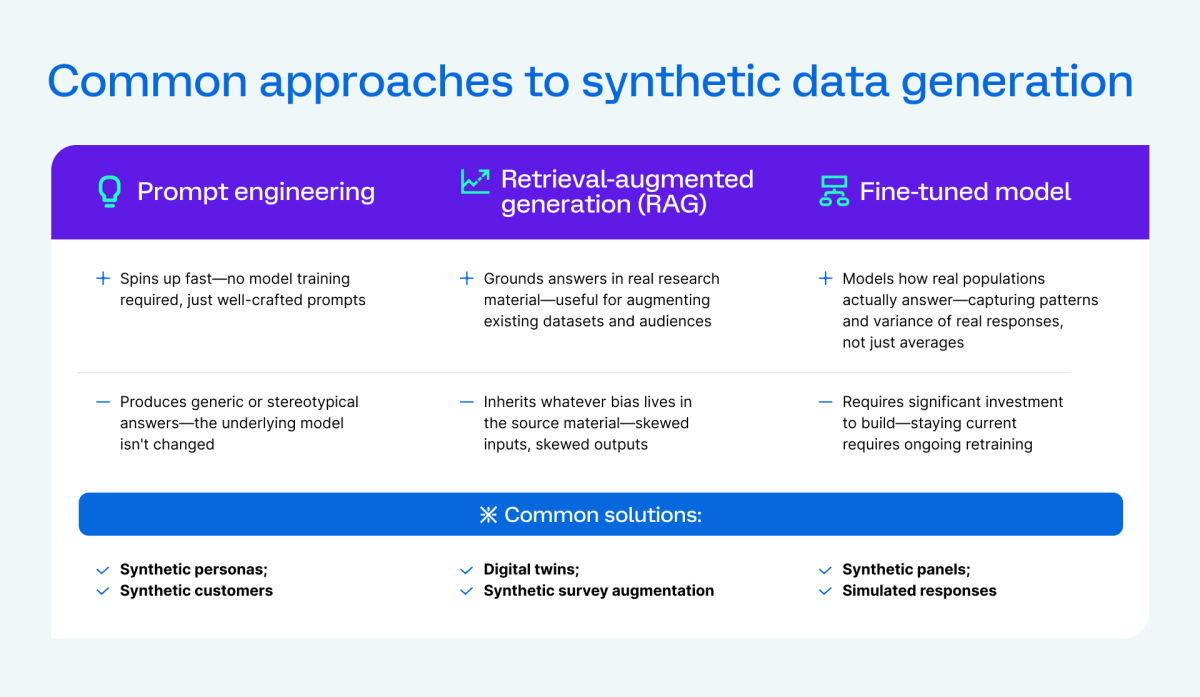
現在市場に流通している製品の多くは、以下の3つのカテゴリーのいずれかに分類されます。
プロンプトエンジニアリングによるシンセティックペルソナは、ユーザーレベルとシステムレベルの指示を組み合わせて、モデルに特定の人物像を演じさせる手法です。こうしたツールは概して、AIペルソナや対話型フォーカスグループなどの名称で提供されることが多く、初期段階の定性的な探求や仮説立案には有効です。しかし、定量的なシミュレーションにおいては限界があります。回答が文化的ステレオタイプに偏ってしまい、モデルをさらにカスタマイズしない限り、実際の人間コミュニティが持つ自然なばらつきを再現できないためです。
RAG(検索拡張生成)によるデジタルツインは、さまざまな文書やインタビューの文字起こし、過去の調査データなどのデータベースを参照させることで、プロンプトのみの手法よりも一歩進んだリアルな回答を生成するモデルです。実在する人間のデータを基盤にできるため、ニッチなターゲット層を分析する際に特に威力を発揮します。一方で、参照先のデータベースに潜むバイアスがそのまま合成データにも引き継がれるという難点があります。基となるデータが偏っていると、モデルが「エコーチェンバー」(似たような考えや価値観、趣味嗜好を持つ人が集まる閉鎖的な空間での偏った回答)に陥るリスクもあります。プロンプトエンジニアリングと同様に、RAGもモデルそのものを改変するのではなく、新たな層を追加して回答の具体性を高めるアプローチと言えます。
ファインチューニングされた専用LLMは、根本的に異なる方法で構築されます。汎用モデルにプロンプトやデータを補足するのではなく、人間のアンケート回答行動を記録したデータセットを用いてLLM自体を再学習させ、回答を生成する内部の仕組みそのものを変化させます。その結果として誕生したモデルは、ペルソナになりきって発言するのではなく、人間の回答者が示す統計的な行動パターンそのものを再現できるようになります。
クアルトリクスはどのようにして合成調査用のモデルを開発したか
クアルトリクスは、 シンセティックオーディエンスを顧客に提供する前の段階で、まずファインチューニングに投資を行いました。プロンプトやRAGだけで汎用モデル調整するのではなく、匿名化された市場調査データに特化して学習させた基礎モデルを開発し、高度な統計分析にも耐えうるアンケート回答を生成できるように最適化しました。このモデルは回答の複雑さやデータ間の相関関係を維持するため、人間のアンケートデータと同等に厳密な分析に対応できる合成データを生成します。検証の結果、クアルトリクスのモデルは、アンケート調査に対する人間の回答を予測する精度において、汎用LLMの 12倍の精度 (EN)を実現することが実証されました。
こうしたモデルの開発には多大な時間と膨大な学習データが必要となるため、業界内でも極めて珍しい取り組みといえます。そのため、本格的な分析を行う段階になると、 ファインチューニングされたシンセティックデータと、プロンプトエンジニアリングによる代替手法との間に、明確な品質の差が生じます。
相乗効果を生むハイブリッドアーキテクチャ
クアルトリクスは、シンセティックオーディエンスに主にファインチューニングを使用していますが、ほかの手法も併用しています。
- ファインチューニング済みのモデルにより、回答の自然なばらつきや人間特有の回答傾向の再現が可能となり、シンセティックデータの統計的信頼性と品質向上を実現できます。
- 次に、プロンプトエンジニアリングによって、個々のアンケート設問に対するモデルの挙動を制御し、データ収集の過程全体において、文脈やペルソナ(回答者像)が一貫して保たれるよう調整します。
- さらに、RAGを使えば、最新の市場情報をAIに参照させられるため、過去の学習データだけに頼らず、最近の動向を反映した回答を作ることができます。
手法を組み合わせる目的は、それぞれの手法が、それぞれ異なる課題に対応しているためです。ファインチューニングは構造的な妥当性を、プロンプトエンジニアリングは文脈の正確性を、RAGは母集団の細かなニュアンスを補います。いずれか1つだけに頼ると、補いきれない部分が残り、データの精度が低下することになります。
この合成調査モデルによって調査チームが得られるメリット
意思決定のスピードアップを求められる一方で、信頼性の要である調査の精度を損なうことが許されない調査部門のリーダーにとって、基盤となるモデルの品質は非常に重要です。高度な統計分析に耐えられないシンセティックデータでは、本当の意味で調査期間の短縮にはなりません。単に「判断が早かったように見えて、実は間違っていた」という結果になるだけだからです。
クアルトリクスは、単一プラットフォーム上で人間の調査パネルや既存の分析ツールと連携できる合成調査機能を開発しました。これにより、調査チームは複数のベンダーを個別に管理したり、ツール間でデータを再統合したりすることなく、個々のプロジェクトに最適な手法を選択できるようになります。データの妥当性を妥協することなく、圧倒的なスピード感とこれまでにない柔軟性をすべての調査担当者に提供する。それが私たちの目標です。
クアルトリクスは基盤モデル開発に先行投資を重ねてきました。それがあるからこそ、意思決定を支える揺るぎない信頼性の高いデータを生み出せるのです。