La recherche synthétique n'est réellement utile que lorsque les données qu'elle produit résistent au même niveau d'analyse que les données issues de panels humains. Dans le cas contraire, les équipes prennent des décisions avec un faux sentiment de confiance. L'écart entre ce que les données semblent démontrer et ce qu'elles permettent réellement de conclure peut alors avoir des conséquences directes sur les résultats de l'entreprise.
Chez Qualtrics, nous avons conçu notre modèle fondamental de données synthétiques pour qu'il résiste à des contrôles statistiques rigoureux. Pour comprendre pourquoi cela est essentiel, il faut examiner la manière dont la plupart des solutions de recherche synthétique sont construites aujourd'hui et les limites que leur architecture peut imposer à la qualité des résultats.
Les limites des modèles d'IA généralistes en recherche synthétique
Un LLM généraliste génère des réponses en prédisant le texte le plus probable à partir d'une requête donnée. Lorsqu'on lui demande de simuler un répondant — par exemple « répondez comme une personne de 28 ans travaillant dans le secteur manufacturier » — il produit des réponses fondées sur les modèles culturels et linguistiques présents dans ses données d'entraînement, principalement issues d'Internet. Pour explorer des hypothèses ou générer des pistes de réflexion, cette approche peut être pertinente.
Les limites apparaissent lorsque les chercheurs cherchent à exploiter ces résultats dans le cadre d'analyses quantitatives. Les populations réelles génèrent naturellement de la variabilité : écarts entre préférences déclarées et comportements observés, réponses non linéaires ou encore fluctuations statistiques reflétant la manière dont les individus prennent leurs décisions dans des situations d'incertitude.
Les modèles généralistes tendent à lisser cette variabilité (EN). Les réponses se concentrent autour de ce qu'un profil type est supposé penser, au lieu de refléter la diversité observée dans un véritable échantillon. Lorsqu'on applique ensuite des méthodes statistiques telles que l'analyse factorielle, le clustering ou l'analyse des points clés, les données générées manquent souvent de la robustesse nécessaire pour produire des résultats fiables.
Il existe différentes techniques permettant de contourner les limites des modèles généralistes. Comprendre leurs spécificités aide à expliquer pourquoi la qualité des résultats varie autant entre les solutions disponibles sur le marché à ce jour.
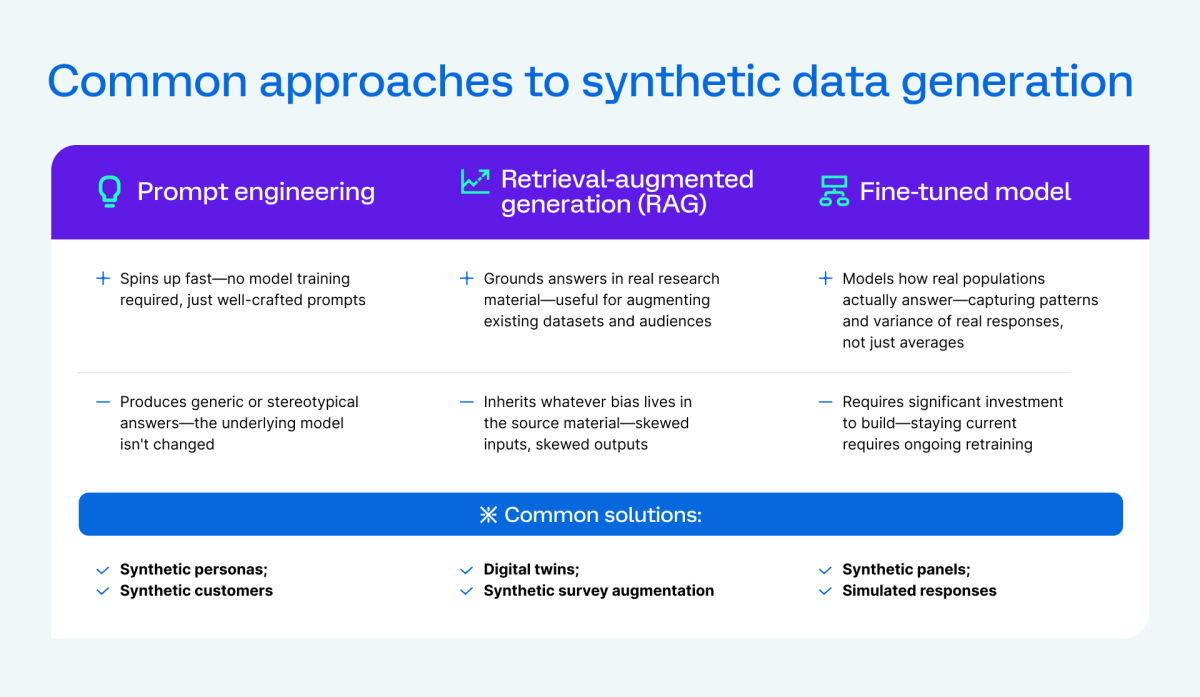
Approches courantes de génération de données synthétiques
La plupart des solutions actuellement disponibles sur le marché appartiennent à l'une des trois catégories suivantes :
Les personas synthétiques basés sur l'ingénierie de prompts orientent le modèle vers un profil d'audience spécifique grâce à une combinaison d'instructions utilisateur et système. Ces solutions sont généralement commercialisées sous la forme de personas IA ou de focus groups conversationnels. Elles offrent une réelle valeur pour l'exploration qualitative précoce et la génération d'hypothèses. Leur principale limite apparaît dans les simulations quantitatives. Sans personnalisation approfondie du modèle, les réponses tendent à se concentrer autour d'archétypes culturels plutôt que de refléter la variabilité réelle observée au sein d'une population.
Les jumeaux numériques basés sur le système de génération augmentée par récupération (RAG - retrieval-augmented generation) vont plus loin en s'appuyant sur une base de connaissances composée de documents, de verbatims d'entretiens ou de données de recherche existantes. Cette approche permet généralement d'obtenir des résultats plus diversifiés et plus réalistes. Le RAG est particulièrement pertinent pour les audiences de niche, lorsque des données humaines réelles permettent d'ancrer plus précisément les réponses du modèle. Sa limite réside dans le fait que les biais présents dans la base documentaire se retrouvent également dans les résultats synthétiques. Lorsque les données sources proviennent d'une population trop restreinte, le modèle risque de reproduire une forme de chambre d'écho. Comme l'ingénierie de prompts, le RAG apporte davantage de contexte et de précision sans modifier fondamentalement le modèle lui-même.
Les modèles LLM affinés (fine-tuned) reposent sur une approche différente dès leur conception. Plutôt que d'adapter ou d'enrichir un modèle généraliste, le fine-tuning consiste à réentraîner un LLM à partir d'un ensemble de données sélectionnées représentant des comportements réels observés dans les enquêtes. Cette approche modifie la manière dont le modèle génère ses réponses à un niveau structurel. Le modèle apprend ainsi à reproduire les comportements statistiques de véritables répondants plutôt qu'à simplement simuler les réponses qu'un persona pourrait fournir.
Comment Qualtrics a conçu son modèle de recherche synthétique
Le fine-tuning constitue l'investissement stratégique réalisé par Qualtrics avant de mettre les audiences synthétiques à disposition de ses clients. Plutôt que de s'appuyer uniquement sur l'ingéniérie de prompts ou le RAG pour adapter un modèle généraliste, les équipes Qualtrics ont développé un modèle fondamental entraîné spécifiquement sur des données d'études de marché anonymisées. Ce modèle a été optimisé pour générer des réponses d'enquête capables de résister à des analyses statistiques rigoureuses. Il préserve la complexité des réponses ainsi que les relations entre les données, garantissant ainsi des données synthétiques exploitables avec le même niveau d'exigence que les données issues d'enquêtes réelles. Les tests réalisés ont démontré que le modèle Qualtrics est 12 fois plus précis (EN) que les LLM généralistes pour prédire les réponses humaines dans les études par enquête.
Un tel niveau de développement nécessite du temps ainsi qu'un volume important de données d'entraînement, ce qui reste relativement rare dans le secteur. C'est également la raison pour laquelle l'écart de qualité entre les données synthétiques issues d'un modèle affiné et les alternatives reposant uniquement sur l'ingénierie de prompts devient rapidement visible dès que les analyses gagnent en complexité.
Comment l'architecture complète crée davantage de valeur
Le fine-tuning constitue le socle de l'approche de Qualtrics en matière d'audiences synthétiques, mais il ne remplace pas les autres méthodes. Il fonctionne en complément de celles-ci.
- Un modèle affiné fournit la base structurelle nécessaire : la variabilité des réponses et la profondeur comportementale qui rendent les données synthétiques statistiquement robustes.
- L'ingénierie de prompts guide ensuite les interactions du modèle avec chaque enquête, en maintenant le contexte approprié ainsi que les caractéristiques du profil étudié tout au long de la collecte des données.
- Le RAG peut compléter cette approche en enrichissant les réponses avec des informations de marché récentes, afin que les résultats reflètent les évolutions actuelles plutôt que de dépendre exclusivement des données historiques utilisées lors de l'entraînement.
Cette combinaison est essentielle, car chaque méthode répond à une dimension différente du problème. Le fine-tuning garantit la validité structurelle des données. L'ingénierie de prompts assure la pertinence contextuelle des réponses. Le RAG apporte les nuances propres aux populations étudiées. S'appuyer sur une seule de ces approches crée inévitablement des lacunes qui finissent par apparaître dans les résultats.
Ce que cela signifie pour les équipes de recherche
Pour les responsables des insights qui doivent produire des résultats plus rapidement sans compromettre la rigueur méthodologique sur laquelle repose leur crédibilité, la qualité du modèle sous-jacent est déterminante. Des données synthétiques qui ne résistent pas à une analyse statistique rigoureuse n'accélèrent pas réellement les projets de recherche. Elles conduisent simplement à des décisions qui semblent rapides, mais qui s'avèrent finalement erronées. Dans toute méthode de recherche orientée insights, la fiabilité des données reste un prérequis indispensable à la qualité des conclusions.
Qualtrics a conçu ses capacités de recherche synthétique pour fonctionner aux côtés des panels humains et des outils d'analyse existants au sein d'une plateforme unique. Les équipes peuvent ainsi choisir la méthode la plus adaptée à chaque étude sans avoir à gérer plusieurs fournisseurs ni à réintégrer les données entre différents outils. L'objectif est d'offrir davantage de flexibilité aux chercheurs sans les obliger à choisir entre rapidité et validité méthodologique. Cette approche permet de combiner efficacement recherche et données synthétiques dans un même environnement de travail.
L'investissement réalisé par Qualtrics dans le développement de son modèle fondamental est ce qui permet de produire des résultats suffisamment fiables pour éclairer la prise de décision et être utilisés en toute confiance.