Synthetische Marktforschung liefert nur dann einen Mehrwert, wenn ihre Ergebnisse genauso belastbar sind wie die Daten aus klassischen Umfragen. Ist das nicht der Fall, entsteht ein falsches Gefühl der Sicherheit. Die Folgen können gravierend sein – denn zwischen dem, was die Daten vermeintlich aussagen, und dem, was sie tatsächlich belegen, liegt oft ein entscheidender Unterschied.
Deshalb haben wir unser Basismodell für synthetische Marktforschung von Grund auf so entwickelt, dass es auch strengen statistischen Prüfungen standhält. Warum das so wichtig ist? Das wird deutlich, wenn man sich ansieht, wie die meisten Lösungen für synthetische Marktforschung heute funktionieren und wo ihre Grenzen liegen.
Synthetische Marktforschung: Wo allgemeine KI-Modelle an ihre Grenzen stoßen
Allgemeine Sprachmodelle (Large Language Models, LLMs) beantworten Fragen, indem sie vorhersagen, welche Antwort statistisch am wahrscheinlichsten ist. Wenn Sie also ein Modell auffordern, die Rolle eines Umfrageteilnehmers zu übernehmen – zum Beispiel eines 28-jährigen aus dem Mittleren Westen der USA, der in der Fertigung arbeitet –, greift es auf Muster und sprachliche Zusammenhänge aus seinen Trainingsdaten zurück. Diese Daten stammen größtenteils aus dem Internet. Für erste Hypothesen kann das durchaus hilfreich sein.
Schwieriger wird es, wenn diese Antworten als Grundlage für quantitative Analysen dienen sollen. Denn echte Umfragedaten zeichnen sich durch natürliche Abweichungen aus: Menschen antworten nicht immer gleich, ihre Präferenzen ändern sich je nach Situation und die Daten weisen eine natürliche Streuung auf, die das reale Entscheidungsverhalten von Menschen unter Unsicherheit widerspiegelt.
Allgemeine KI-Modelle gleichen diese Varianz aus (EN). Die Antworten orientieren sich an dem, was eine Persona „typischerweise“ denkt, anstatt die Verteilung einer realen Stichprobe abzubilden. Werden diese Daten anschließend mit Faktorenanalysen, Clusteranalysen oder Treiberanalysen ausgewertet, fehlt ihnen meist die statistische Belastbarkeit, die diese Methoden voraussetzen.
Es gibt verschiedene Ansätze, mit denen sich die Einschränkungen allgemeiner KI-Modelle umgehen lassen. Um zu verstehen, warum die Ergebnisse der heute verfügbaren Lösungen für synthetische Marktforschung so unterschiedlich ausfallen, ist es wichtig, die Unterschiede zwischen diesen Ansätzen zu verstehen.
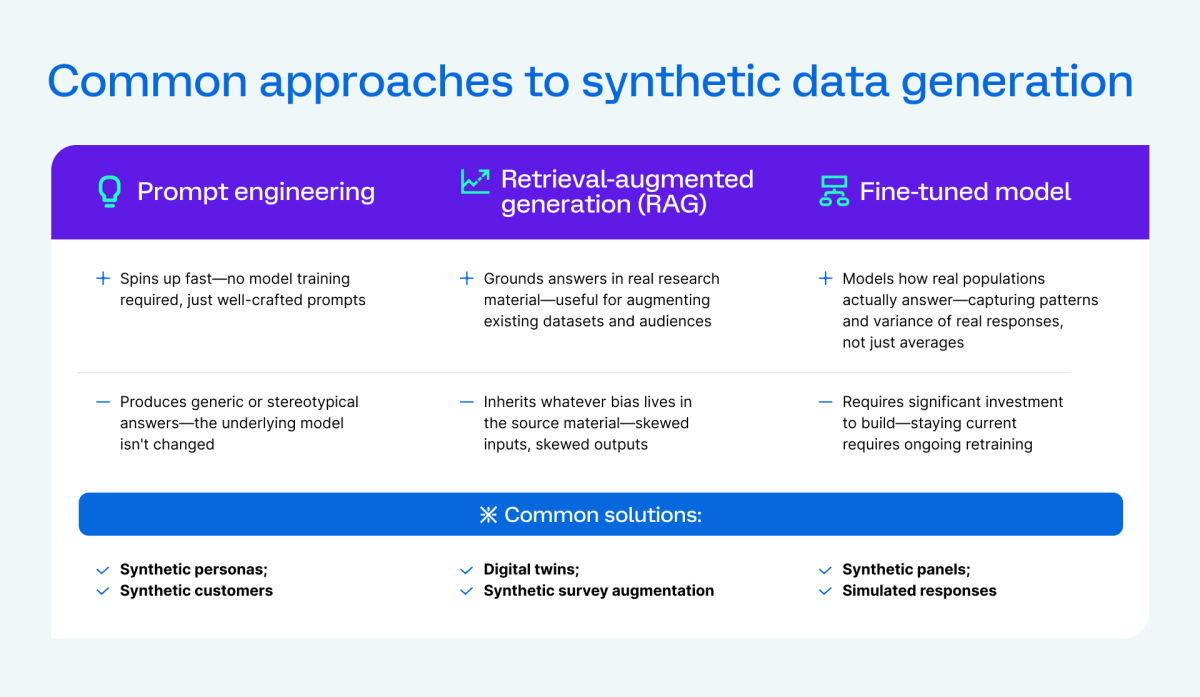
Gängige Ansätze zur Generierung synthetischer Daten für die Marktforschung
Die meisten aktuell verfügbaren Lösungen lassen sich heute in drei Kategorien einteilen:
Auf Basis von Prompt Engineering erstellte synthetische Personas bringen das Modell durch eine Kombination aus Anweisungen auf Nutzer- und Systemebene dazu, die Rolle einer bestimmten Zielgruppe einzunehmen. Solche Lösungen werden häufig als KI-Personas oder KI-gestützte Fokusgruppen vorgestellt und eignen sich gut für erste qualitative Analysen oder zur Entwicklung von Hypothesen. Bei quantitativen Simulationen stoßen sie jedoch an ihre Grenzen. Wenn diese Modelle nicht individuell angepasst werden, spiegeln die Antworten lediglich das wieder, was für eine Persona als typisch gilt, statt die natürliche Varianz einer realen Gruppe abzubilden.
Auf Basis von Retrieval-Augmented Generation (RAG) generierte Digitale Zwillinge gehen einen Schritt weiter. Sie verankern das Modell in einer kuratierten Datenbasis aus Dokumenten, Interviewtranskripten oder bereits vorhandenen Forschungsdaten und erzeugen so vielfältigere und realistischere Antworten. Besonders bei Nischenzielgruppen spielt RAG seine Stärken aus, weil reale Daten die Antworten des Modells gezielter steuern können. Der Nachteil: Verzerrungen in der zugrunde liegenden Datenbasis werden auch in die synthetischen Ergebnisse übernommen. Stammt die Datenbasis nur aus einer begrenzten Zielgruppe, besteht die Gefahr, dass das Modell Antworten in einer Art Echokammer erzeugt. Wie Prompt Engineering sorgt auch RAG für mehr Spezifität, ohne das Modell selbst zu verändern.
Individuell abgestimmte Sprachmodelle verfolgen einen anderen Ansatz. Statt ein allgemeines Modell zu steuern oder zu ergänzen, wird es mit einem kuratierten Datensatz aus realen Antworten in Umfragen nachtrainiert. Dadurch verändert sich auf struktureller Ebene die Art und Weise, wie das Modell Antworten erzeugt. Das Ergebnis: Das Modell lernt, das statistische Antwortverhalten realer Teilnehmer nachzubilden, anstatt lediglich zu simulieren, was eine bestimmte Persona sagen würde.
So hat Qualtrics sein Modell für die synthetische Marktforschung entwickelt
Bevor Qualtrics synthetische Zielgruppen für Kunden verfügbar machte, wurde das zugrunde liegende Sprachmodell individuell abgestimmt. Anstatt ein allgemeines Modell durch Prompt Engineering oder RAG anzupassen, entwickelten wir ein Basismodell, das speziell mit anonymisierten Marktforschungsdaten trainiert wurde. Das Ziel: Umfrageantworten zu erzeugen, die auch anspruchsvollen statistischen Analysen standhalten. Dafür bildet das Modell sowohl die Komplexität menschlicher Antworten als auch die Zusammenhänge innerhalb der Daten zuverlässig ab. So entstehen synthetische Daten, die dieselben methodischen Anforderungen erfüllen wie Daten aus realen Befragungen. Tests zeigen, dass das Qualtrics-Modell menschliche Antworten in Umfragen 12-mal so präzise (EN) vorhersagt wie allgemeine Sprachmodelle.
Eine solche Entwicklung erfordert Zeit sowie umfangreiche Trainingsdaten und ist in der Branche nach wie vor eher die Ausnahme. Sobald anspruchsvollere Analysen durchgeführt werden, sind die Qualitätsunterschiede zwischen individuell abgestimmten synthetischen Daten und promptbasierten Alternativen meist sehr deutlich.
So entfaltet die synthetische Architektur ihr volles Potenzial
Die individuelle Abstimmung des Modells bildet das Fundament der Qualtrics-Lösung für synthetische Zielgruppen. Ihre volle Wirkung entfaltet sie jedoch erst im Zusammenspiel mit zwei weiteren Ansätzen.
- Das individuell abgestimmte Modell schafft die Grundlage: Es bildet die Variabilität von Antworten und die Komplexität menschlichen Verhaltens so ab, dass die synthetischen Daten auch statistisch belastbar sind.
- Durch Prompt Engineering wird dann gesteuert, wie das Modell mit einem bestimmten Erhebungsinstrument umgeht. So bleiben während der gesamten Datenerhebung der richtige Kontext und die Merkmale der jeweiligen Persona erhalten.
- Durch RAG wird diese Grundlage schließlich ergänzt, indem aktuelle Marktinformationen in die Antworten einfließen. So spiegeln die Ergebnisse auch neue Entwicklungen wider und basieren nicht ausschließlich auf den Trainingsdaten des Modells.
Die Kombination dieser Ansätze ist entscheidend, weil jeder von ihnen einen anderen Aspekt des Problems löst. Die individuelle Abstimmung sorgt für statistische Belastbarkeit, Prompt Engineering für den richtigen Kontext und RAG für eine realistische Abbildung der jeweiligen Zielgruppe. Wird nur einer dieser Ansätze eingesetzt, entstehen Lücken, die sich später in den Daten bemerkbar machen.
Was das für Marktforschungsteams bedeutet
Verantwortliche im Bereich Marktforschung stehen unter Druck: Sie müssen immer schneller Erkenntnisse gewinnen, ohne an Qualität einzubüßen. Deshalb ist die Qualität des zugrunde liegenden Modells so wichtig. Denn synthetische Daten, die einer statistischen Prüfung nicht standhalten, sorgen nicht für schnellere Ergebisse – sondern führen schneller zu falschen Entscheidungen.
Qualtrics hat seine Funktionen für synthetische Forschung so konzipiert, dass sie auf einer gemeinsamen Plattform mit menschlichen Panels und beretis vorhandenen Analysetools verwendet werden können. So können Forschungsteams für jede Studie die passende Methode wählen, ohne mit mehreren Anbietern zusammenarbeiten oder Daten aus verschiedenen Tools zusammenführen zu müssen. Ziel ist es, Marktforschenden mehr Flexibilität zu geben, ohne dass die Geschwindigkeit zulasten der Validität geht.
Weil Qualtrics in die Entwicklung seines Basismodells investiert hat, können Sie darauf vertrauen, dass die Ergebnisse belastbar sind und fundierte Entscheidungen ermöglichen.