La investigación sintética es útil si los datos que genera resisten el mismo escrutinio analítico que cualquier otro tipo de investigación. De lo contrario, las decisiones se basan en conclusiones sin respaldo y pueden afectar a los resultados comerciales.
Para evitarlo, en Qualtrics diseñamos un modelo sintético que cumple con los análisis estadísticos más rigurosos. ¿Por qué es esto importante? A fin de comprenderlo, debemos explorar el diseño de la mayoría de las herramientas de investigación sintética y las limitaciones de su arquitectura subyacente.
Las limitaciones de los modelos de IA general con datos sintéticos
Los modelos de lenguaje grande (LLM) generales predicen la respuesta más probable a una pregunta específica. Cuando se les pide que simulen a un tipo de persona (“responde como una persona de 28 años que trabaja en fabricación en la zona oeste”), generan respuestas a partir de los patrones culturales y las normas lingüísticas incorporados en sus datos de entrenamiento, los cuales, en gran parte, provienen de Internet. Esto puede resultar útil para las hipótesis iniciales.
El problema surge con los análisis cuantitativos. Las poblaciones reales generan datos con una variación natural: incoherencias entre las preferencias declaradas y las reales, patrones de respuesta no lineales y diferencias en la distribución que reflejan la toma de decisiones real en situaciones de incertidumbre.
Los modelos de uso general uniformizan esa variación (EN). Las respuestas simulan lo que la persona “habitualmente” cree, sin las distribuciones naturales de una muestra real. Si se realiza un análisis factorial, un análisis de clústeres o un análisis de impulsores clave, se suele detectar una falta de integridad estructural en los datos.
Los investigadores pueden aplicar estas técnicas para superar las limitaciones de estos modelos. Para una investigación estratégica, deben comprender por qué las distintas herramientas de investigación disponibles en el mercado generan resultados tan distintos entre sí.
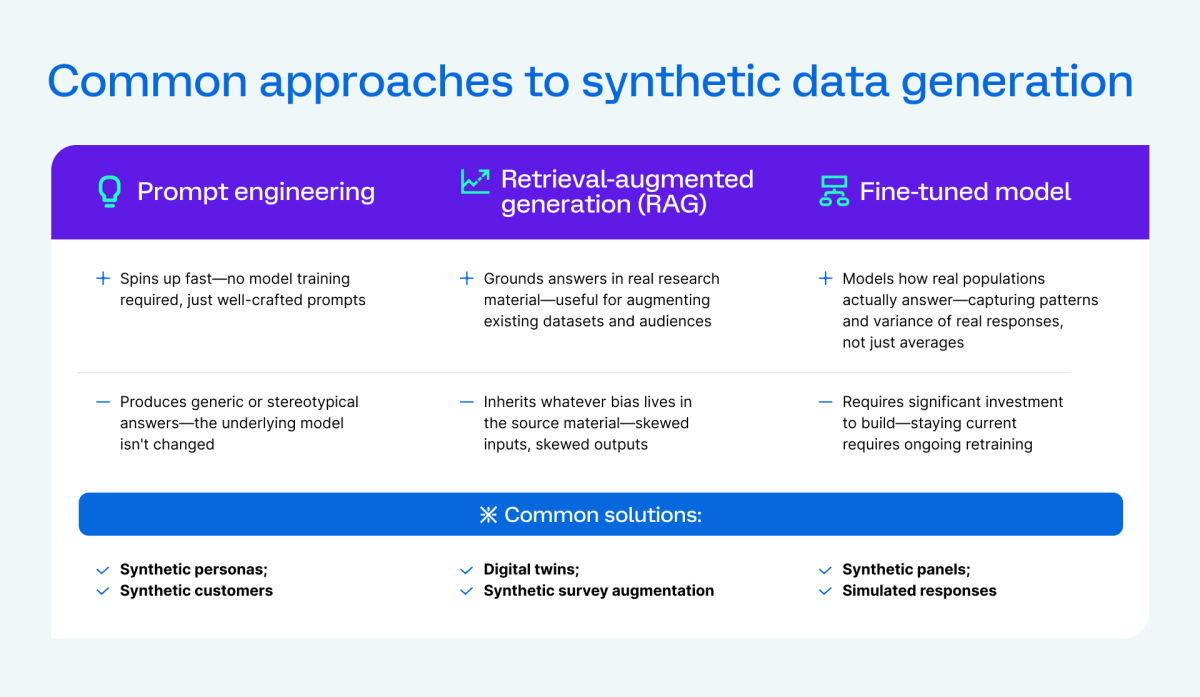
Enfoques habituales para la generación de datos sintéticos
La mayoría de los productos disponibles en el mercado se clasifican en tres categorías:
Perfiles sintéticos creados con ingeniería de prompts: una combinación de instrucciones del usuario y el sistema indica al modelo que adopte un perfil de audiencia. Este modelo suele promocionarse como “perfiles de inteligencia artificial” o “grupos de debate conversacionales”, y es muy útil para la exploración cualitativa inicial y la generación de hipótesis. Los problemas surgen con la simulación cuantitativa: sin una personalización detallada, las respuestas tienden a agruparse en arquetipos culturales sin reflejar la variación auténtica de una población real.
Gemelos digitales con generación aumentada por recuperación (RAG): a partir de una base de datos seleccionada de documentos, transcripciones de entrevistas o datos de investigaciones previas, el modelo genera resultados más variados y, en apariencia, más reales. Resulta especialmente útil para audiencias específicas, ya que los datos de personas reales pueden generar respuestas más precisas. Su limitación es que los datos sintéticos replican cualquier sesgo de la base de datos. Además, si los datos provienen de una población limitada, el modelo puede generar respuestas repetitivas. Al igual que la ingeniería de prompts, la RAG agrega un nivel de especificidad, pero no modifica al modelo en sí para una investigación estratégica.
Modelos de LLM optimizados: aplican un diseño totalmente distinto. En lugar de adaptar o complementar un modelo general, se lo vuelve a entrenar con un conjunto seleccionado de datos a partir de respuestas reales a encuestas. Se trata de un cambio estructural en la manera de simular respuestas. El modelo resultante aprende a reproducir el comportamiento estadístico de los encuestados reales, en lugar de simular lo que diría un personaje ficticio.
Las herramientas de investigación con datos sintéticos de Qualtrics
Antes de ofrecer herramientas de audiencias sintéticas a sus clientes, Qualtrics invirtió en el diseño de un modelo optimizado y entrenado con datos anonimizados de investigaciones de mercados reales, en lugar de adaptar un modelo general con prompts o la RAG. De este modo, se generan respuestas que superan los análisis estadísticos más rigurosos, al replicar la complejidad de las respuestas y las relaciones entre datos de las encuestas reales. Según diversas pruebas, el modelo de Qualtrics predice la respuesta humana con una precisión 12 veces mayor (EN) que los LLM generales.
Ese tipo de desarrollo lleva tiempo y requiere una gran cantidad de datos de entrenamiento, por lo que existen muy pocos en el mercado. Sin embargo, la diferencia de calidad entre los datos sintéticos optimizados (EN) y los modelos con ingeniería de prompts es evidente en análisis más complejos.
Los beneficios de una arquitectura integral
La diferenciación fundamental del enfoque de audiencias sintéticas de Qualtrics es la optimización, que se combina con los otros métodos, en lugar de reemplazarlos:
- La estructura se basa en un modelo optimizado, con una variabilidad de respuestas y una diversidad de comportamientos que garantizan su validez estadística para una investigación estratégica.
- La ingeniería de prompts orienta la aplicación del modelo a cada encuesta específica, con el contexto adecuado y las características de perfiles a lo largo de la recopilación de datos.
- La RAG adapta las respuestas al mercado actual para que los resultados reflejen siempre los acontecimientos más recientes, más allá de los datos de entrenamiento históricos.
Cada método aborda una dimensión diferente del problema. La optimización garantiza la validez estructural. La ingeniería de prompts brinda precisión contextual. La RAG aporta los matices de cada población. Cuando las herramientas de investigación se basan en uno solo de estos métodos, los datos resultantes no son confiables.
La mejor estrategia del equipo de investigación
Los equipos de investigación actuales deben generar resultados rápidos sin comprometer el rigor ni la credibilidad de su trabajo. Para lograrlo, necesitan contar con un modelo de calidad. Los datos sintéticos que no resisten un análisis estadístico dan lugar a decisiones rápidas, pero con consecuencias dañinas para el negocio.
Al combinar las capacidades de investigación sintética con los paneles humanos y las herramientas de investigación existentes en una sola plataforma, Qualtrics aplica el método adecuado para cada estudio de forma integral, sin necesidad de migraciones entre herramientas. De este modo, los investigadores cuentan con la agilidad, la flexibilidad y la solidez que necesitan.
La inversión de Qualtrics en su modelo garantiza resultados precisos para una toma de decisiones confiable.