ファイルからの会話データの抽出
このページの内容
ファイルからの会話データの抽出について
チャット、メールスレッド、通話記録など、顧客とサポートのやり取りの記録が、会話データとなります。会話データには、充実した自由回答のフィードバックが含まれている可能性があり、顧客対応担当者が顧客に最高のサービスを提供する方法を指導する機会となります。
サーバーからクアルトリクスにデータを移行すると、クアルトリクスの豊富なオムニチャネルリスニング機能を使用して、この種の会話分析を実行できます。
ヒント:Amazon S3またはSFTPを使用して音声プロジェクトに通話データを送信する場合、サポートされるのは文字起こしされた通話記録のみです。音声ファイルはサポートされていません。音声テキスト変換については、その他のオプションを参照してください。

サポートされているファイルソース
現在、以下のソースから通話記録、チャット、メールのファイルを抽出できます。
- サーバーとのセキュアファイル転送プロトコル:SFTPファイルからデータを抽出タスク
- Amazon Simple Storage Service: Amazon S3 からデータを抽出タスク
注意:これらのタスクで会話データ設定を使用することは、導入サービスをご購入いただいた場合にのみ推奨されます。会話分析は、 オムニチャネルリスニング管理の一環として、 チャット、音声、 メールの各プロジェクトで使用するためのものです。詳細および 権限については、リンク先のページを参照してください。

会話データのフォーマット設定
会話データは、書き起こされた形式である必要があります。例えば、文字起こしされた通話のトランスクリプトはサポートされていますが、音声ファイルはサポートされていません。
注意:会話データをサーバーに保存する際は、クアルトリクスのサンプルファイルを使用することを強く推奨します。
ファイルはUTF-8エンコーディングのTSVまたはCSVとして保存してください。ファイルに、データフィールドに対応する列ヘッダーを含むヘッダー行があることを確認してください。
ファイルの各行が、個別のインタラクションとなるようにしてください。複数のインタラクションがある会話の場合、これらのインタラクションはファイル内で会話IDフィールドによってグループ化される必要があります。詳細については、DigitalインタラクションのCSVおよびExcelのフォーマットを参照してください。
会話データの抽出
スタンドアロンワークフローに移動し、ETLワークフローを作成します。
データソース(ETLエクストラクタ)には、次のいずれかのタスクを選択します。
タスクの設定を開始します。選択したタスクによっては、アカウントへの接続、ファイルパスの定義、バケットの指定などが必要になる場合があります。
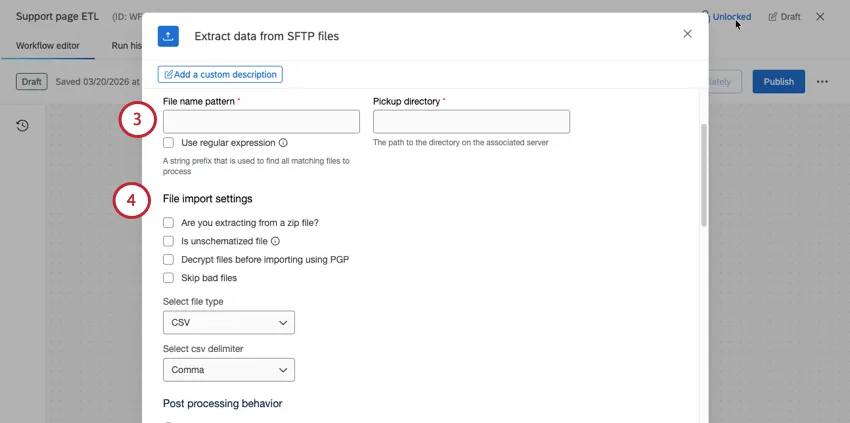
ヒント:会話データに関連しない手順については、タスク固有のサポートページを参照してください。
希望するファイルインポート設定を選択します。
注意: スキーマ化されていないファイルは、会話データと互換性がありません。それ以外の場合、他のすべてのファイルインポート設定には互換性があります。
必要に応じて後処理の動作を設定します。
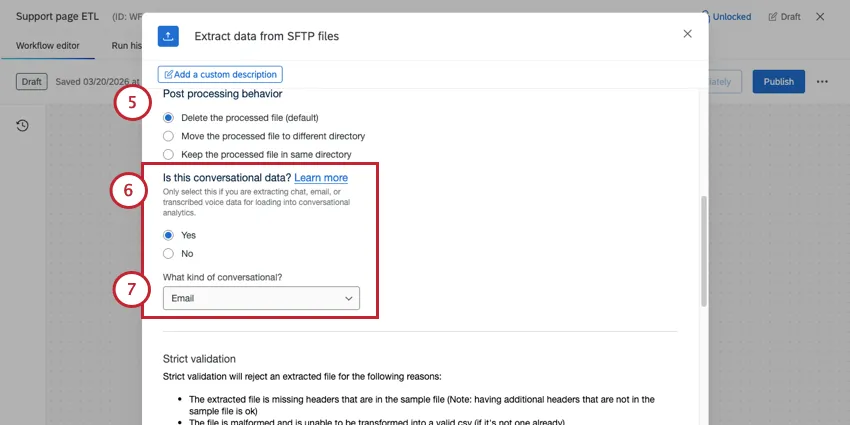
これは会話データですかでは、はいを選択する必要があります。
以下の会話データタイプのいずれかを選択してください。
必要に応じて検証を設定します(SFTP のみ)。
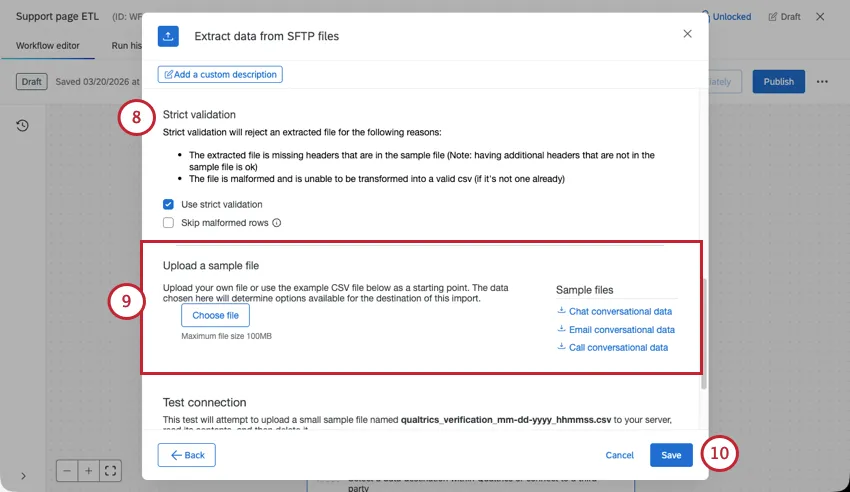
サンプルファイルをアップロードする際は、以下を使用することをお勧めします。 サンプルファイルのいずれかです。
タスクを完了してください。
では、会話分析にデータを読み込みましょう。手順については、リンク先のページを参照してください。
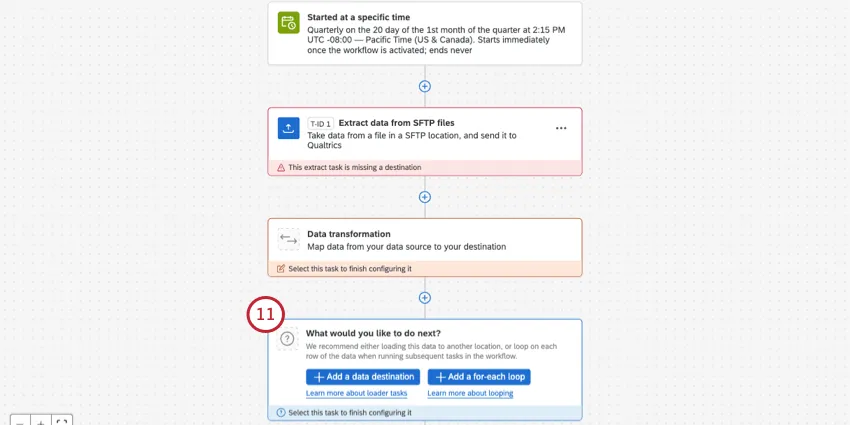
ヒント:このタスクで既存の音声プロジェクトを選択する場合、会話分析タスクへのデータ読み込みで作成された音声プロジェクトのみを選択できます。これは、通話の文字起こしを処理する音声プロジェクトと、音声テキスト変換(GenesysまたはNiceCXoneを使用)を可能にする音声プロジェクトとでは、若干の違いがあるためです。
ワークフローが完了すると、選択したスケジュールでデータがクアルトリクスに追加されます。このデータは、自動トピックで分析したり、ダッシュボードを構築したりできます。
素晴らしい! フィードバックありがとうございます!
フィードバックありがとうございます!